Ist N+1 noch N+1? Redundanz im Bestand prüfen
Wie prüfen wir, ob die geplante Redundanz nach Jahren mit Lastwachstum und Umbauten im Störfall noch funktioniert?
Wer ein Rechenzentrum betreibt, verlässt sich auf eine Grundannahme: Die Redundanz, die beim Bau geplant wurde, ist noch vorhanden. N+1 bei der Kühlung bedeutet, dass eine Einheit ausfallen kann, ohne dass die Versorgung zusammenbricht. Doch diese Annahme stimmt nur dann, wenn die Last nicht gewachsen ist, die Sollwerte nicht verändert wurden und die Steuerungslogik noch so funktioniert wie ursprünglich vorgesehen. In der Praxis treffen wir regelmässig auf Anlagen, bei denen keiner dieser drei Punkte zutrifft.
Dieser vierte Teil der Serie zeigt, wie wir im Bestand systematisch prüfen, ob die geplante Redundanz im Störfall noch real ist. Es geht um die Kapazitätsbilanz der Kühlung, das Umschaltverhalten der Leittechnik, den Wiederanlauf nach Netzausfall und die Frage, wie man solche Tests im laufenden Betrieb durchführt, ohne die Verfügbarkeit zu gefährden.
Was N+1 bedeutet und was es nicht garantiert
Der Begriff N+1 beschreibt eine Redundanzstrategie: N bezeichnet die Anzahl der Einheiten, die für den Betrieb unter Volllast benötigt werden. Die eine zusätzliche Einheit steht als Reserve bereit. Fällt eine Einheit aus, übernehmen die verbleibenden N Einheiten die Last vollständig. Das Uptime Institute verwendet diese Logik in seinen Tier-Definitionen, und die EN 50600-1 beschreibt Verfügbarkeitsklassen, die ähnliche Redundanzanforderungen formulieren.
Was diese Definitionen nicht garantieren, ist die Aktualität der Ausgangsgrösse N. N ist keine feste Zahl, sondern hängt von der tatsächlichen Last ab. Wenn die IT-Last im Rechenzentrum über die Jahre gewachsen ist, hat sich N verändert. Wenn die Kältemaschinen mit höheren Vorlauftemperaturen betrieben werden als ursprünglich ausgelegt, hat sich die verfügbare Kapazität verändert. Wenn Umbauten dazu geführt haben, dass einzelne Kühleinheiten bestimmte Bereiche nicht mehr erreichen, hat sich die Topologie verändert. In all diesen Fällen kann die Anlage auf dem Papier noch N+1 sein, im Störfall aber nicht mehr.
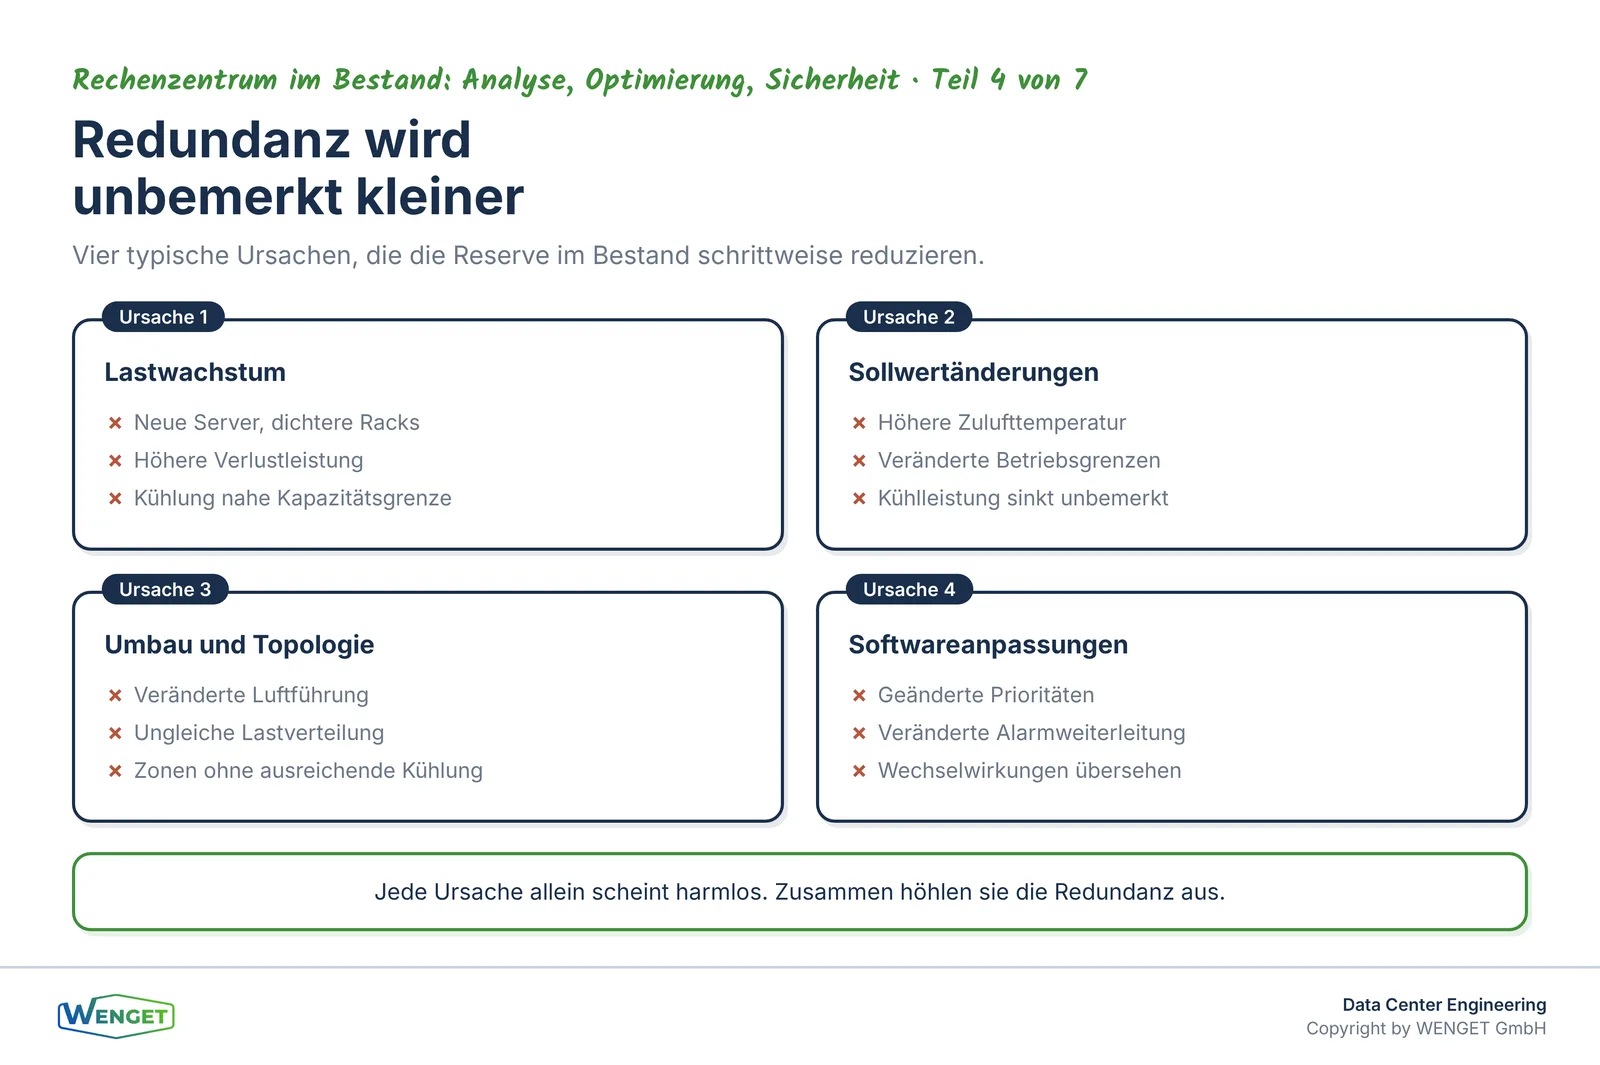
Genau hier liegt das eigentliche Risiko: Die Redundanz ist nicht verschwunden, weil jemand einen Fehler gemacht hat. Sie ist unbemerkt ausgehöhlt worden, weil viele kleine Veränderungen zusammengekommen sind, die jede für sich harmlos schienen.
Lastwachstum als stiller Redundanzkiller
Das häufigste Muster, das wir in Bestandsanlagen antreffen, ist das schleichende Lastwachstum. Neue Server werden eingebaut, bestehende Racks werden dichter bestückt, Hochleistungsrechner ersetzen ältere Geräte mit deutlich höherer Verlustleistung. Die Kühlung wurde für eine bestimmte Gesamtlast ausgelegt. Diese Last ist längst überschritten, aber niemand hat die Redundanzbilanz neu gerechnet.
In der Praxis bedeutet das: Alle vorhandenen Kühleinheiten laufen bereits im Normalbetrieb nahe an ihrer Kapazitätsgrenze. Die Reserve, die N+1 verspricht, existiert nur noch auf dem Papier. Fällt eine Einheit aus, können die verbleibenden die Last nicht mehr vollständig übernehmen. Die Raumtemperatur steigt, die IT-Systeme drosseln ihre Leistung oder schalten ab.
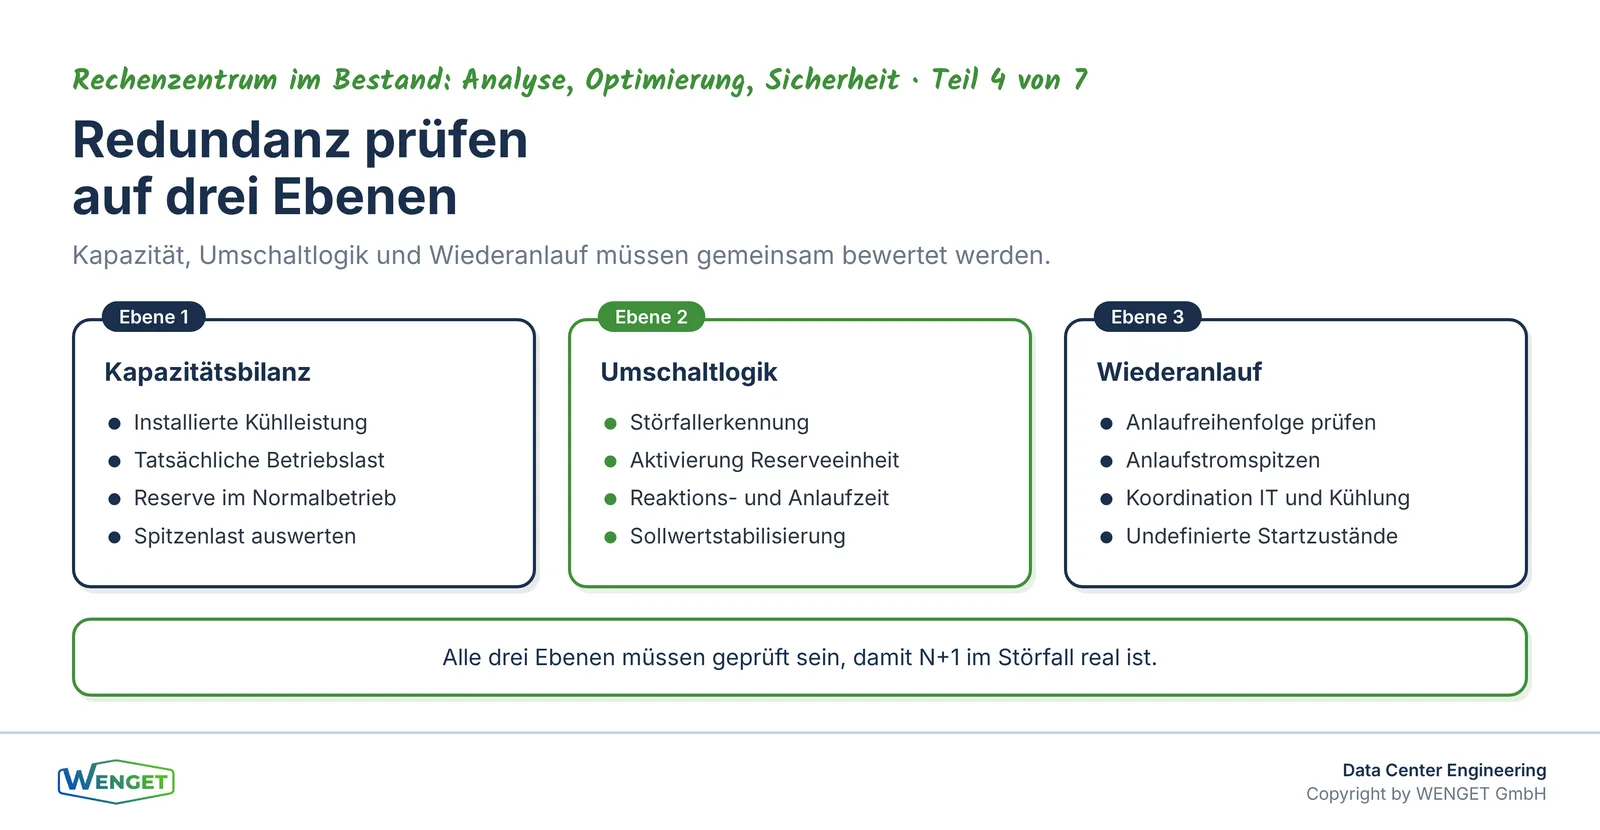
Um das zu erkennen, braucht es eine Kapazitätsbilanz. Wir erheben dazu die installierte Kühlleistung aller Einheiten, die tatsächliche Betriebslast im Normalbetrieb und die Spitzenlast über einen repräsentativen Zeitraum. Aus diesen Werten lässt sich berechnen, wie viel Reserve im Normalbetrieb tatsächlich vorhanden ist und ob diese Reserve ausreicht, um den Ausfall einer Einheit zu kompensieren. Trenddaten aus dem Leitsystem sind dabei unverzichtbar. Wie man solche Daten liest und interpretiert, haben wir in Teil 2 dieser Serie, «Was die Trenddaten über Ihre Kühlung verraten», ausführlich beschrieben.
Ein weiterer Aspekt ist die Lastverteilung zwischen den Einheiten. Wenn einzelne Kühleinheiten durch bauliche Veränderungen oder veränderte Luftführung bestimmte Zonen nicht mehr gleichmässig versorgen, entsteht eine ungleiche Last. Im Störfall kann dann eine Einheit ausfallen, die gerade die am stärksten belastete Zone versorgt, und die verbleibenden Einheiten können diese Zone nicht ausreichend kühlen, auch wenn ihre Gesamtkapazität rechnerisch ausreicht.
Veränderte Sollwerte und ihre Folgen
Neben dem Lastwachstum sind veränderte Sollwerte eine häufige Ursache dafür, dass die Redundanz nicht mehr das hält, was sie verspricht. Sollwertänderungen passieren aus guten Gründen: Energieoptimierung, veränderte IT-Anforderungen, Anpassungen nach Umbau. Aber sie haben Konsequenzen für die verfügbare Kapazität, die nicht immer mitgedacht werden.
Ein typisches Beispiel ist die Anhebung der Zulufttemperatur im Rahmen einer Betriebsoptimierung. ASHRAE TC 9.9 empfiehlt für den Zulufttemperaturbereich Werte zwischen 18 und 27 Grad Celsius. Viele Rechenzentren wurden ursprünglich mit niedrigeren Sollwerten betrieben. Wenn dieser Sollwert angehoben wird, sinkt der Energieverbrauch der Kühlung, aber die Kühleinheiten arbeiten mit einer geringeren Temperaturdifferenz. Das kann die nutzbare Kühlleistung pro Einheit reduzieren, abhängig von der Anlagentechnik und den hydraulischen Verhältnissen.
Ähnliches gilt für Änderungen an der Rückkühlung oder an den Betriebsgrenzen der Kältemaschinen. Wenn der Betriebspunkt verschoben wird, ändert sich die tatsächlich verfügbare Leistung. Diese Änderungen werden in der Regel nicht systematisch mit der Redundanzbilanz abgeglichen. Das Ergebnis ist eine Anlage, die energetisch optimiert wurde, aber deren Redundanzreserve dabei geschrumpft ist.
Wir empfehlen deshalb, jede Sollwertänderung, die die Kapazität der Kühlung beeinflusst, mit einer aktualisierten Redundanzbilanz zu verbinden. Das ist kein grosser Aufwand, wenn die Grundlagen vorhanden sind. Fehlen diese Grundlagen, ist die Bilanz selbst der erste notwendige Schritt.
Umschaltlogik: Was die Leittechnik im Störfall tut
Die Kapazitätsbilanz ist die eine Seite der Redundanzprüfung. Die andere Seite ist das Verhalten der Leittechnik im Störfall. Selbst wenn die Kapazität rechnerisch ausreicht, nützt sie nichts, wenn die Umschaltung nicht funktioniert.
Umschaltlogiken in Rechenzentren sind oft komplex. Sie berücksichtigen Prioritäten, Betriebszustände, Verriegelungen und Zeitverzögerungen. Diese Logiken wurden bei der Inbetriebnahme programmiert und getestet. Seitdem wurden Softwareupdates eingespielt, Parameter angepasst, neue Geräte integriert und Schnittstellen verändert. Jede dieser Änderungen kann das Umschaltverhalten beeinflussen, ohne dass dies sofort sichtbar wird.
In der Praxis sehen wir drei häufige Probleme. Erstens: Die Umschaltung löst aus, aber die Reserveeinheit startet nicht oder startet zu langsam, weil eine Verriegelung aktiv ist, die ursprünglich für einen anderen Betriebszustand gedacht war. Zweitens: Die Umschaltung funktioniert, aber die Regelung der Reserveeinheit braucht zu lange, um den Sollwert zu erreichen, weil die Anlaufparameter nicht auf den Störfall ausgelegt sind. Drittens: Die Umschaltung funktioniert unter Normalbedingungen, aber nicht unter den Bedingungen, die im Störfall tatsächlich vorliegen, zum Beispiel bei hoher Aussentemperatur oder bei gleichzeitigem Ausfall mehrerer Komponenten.
Diese Probleme sind nur durch einen gezielten Test sichtbar zu machen. Eine Dokumentenprüfung reicht nicht aus. Die Logik muss im realen Betrieb oder in einer kontrollierten Testsituation beobachtet werden. Wie solche Tests im Betrieb durchgeführt werden können, ohne die Verfügbarkeit zu gefährden, beschreiben wir weiter unten.
Wiederanlauf nach Netzausfall
Ein besonderer Fall der Umschaltlogik ist der Wiederanlauf nach einem Netzausfall. Dieser Fall unterscheidet sich grundlegend von einem einfachen Geräteausfall, weil alle Systeme gleichzeitig betroffen sind und der Wiederanlauf koordiniert erfolgen muss.
Typische Probleme beim Wiederanlauf sind Anlaufstromspitzen, die die Netzversorgung überlasten, falsche Anlaufreihenfolgen, die dazu führen, dass Kühlung und IT-Systeme nicht synchron hochfahren, und Regelungslogiken, die nach einem Netzausfall in einem undefinierten Zustand starten. Hinzu kommen Wechselwirkungen zwischen USV-Systemen, Notstromaggregaten und der Gebäudeautomation, die im Normalbetrieb nie sichtbar werden.
Der Wiederanlauf ist ein Szenario, das in vielen Rechenzentren seit der Inbetriebnahme nicht mehr vollständig getestet wurde. Softwareupdates, neue Geräte und veränderte Lastprofile haben die Ausgangssituation verändert. Ob der Wiederanlauf noch so funktioniert wie geplant, ist ohne Test nicht bekannt.
Wir empfehlen, den Wiederanlauf als eigenständiges Testszenario zu behandeln und nicht als Teil eines allgemeinen Funktionstests. Die Anforderungen an Dokumentation und Vorbereitung sind höher, und die Konsequenzen eines Fehlers im Test sind grösser. Deshalb braucht dieser Test ein eigenes Wartungsfenster, eine klare Rollenzuweisung und einen definierten Abbruchplan.
Softwareanpassungen und ihre unsichtbaren Folgen
Softwareanpassungen an der Leittechnik sind im laufenden Betrieb unvermeidlich. Parameter werden angepasst, Regelkreise optimiert, Schnittstellen aktualisiert. Was dabei oft fehlt, ist eine systematische Prüfung, ob diese Anpassungen das Redundanzverhalten beeinflusst haben.
Ein Beispiel: Ein Integrator passt die Prioritäten in der Umschaltlogik an, um ein Betriebsproblem zu lösen. Die Anpassung löst das Problem. Aber sie verändert auch die Reihenfolge, in der Reserveeinheiten aktiviert werden. Im nächsten Störfall startet die falsche Einheit zuerst, und die Reaktionszeit ist länger als erwartet.
Ein anderes Beispiel: Ein Softwareupdate der Managementebene verändert die Art, wie Alarme weitergeleitet werden. Die Umschaltlogik selbst ist unverändert, aber die Alarmierung, die den Operator auf den Störfall aufmerksam machen soll, funktioniert nicht mehr zuverlässig. Der Störfall wird zu spät erkannt.
Diese Probleme sind nicht auf Fehler der Integratoren zurückzuführen. Sie entstehen, weil Softwareanpassungen in komplexen Systemen Wechselwirkungen haben, die im Voraus nicht immer erkennbar sind. Das Gegenmittel ist ein strukturiertes Änderungsmanagement, das jede Anpassung dokumentiert und mit einer Prüfung des betroffenen Verhaltens verbindet. Wie ein solches Änderungsmanagement in der Leittechnik aufgebaut wird, haben wir in Teil 1 dieser Serie, «Leittechnik-Check im bestehenden Rechenzentrum», beschrieben.
Tests im Betrieb: Wie das geht und was es braucht
Die zentrale Frage für Betreiber ist: Wie testet man die Redundanz, ohne den Betrieb zu gefährden? Die Antwort ist nicht einfach, aber sie ist strukturierbar.
Der erste Schritt ist die Unterscheidung zwischen Tests, die ohne Betriebsunterbrechung möglich sind, und Tests, die ein Wartungsfenster erfordern. Viele Prüfungen der Kapazitätsbilanz und der Dokumentation sind ohne Eingriff in den Betrieb möglich. Die Auswertung von Trenddaten, die Überprüfung der Sollwerte und die Analyse der Umschaltlogik in der Dokumentation erfordern keinen Eingriff in die laufende Anlage.
Tests des tatsächlichen Umschaltverhaltens erfordern dagegen einen kontrollierten Eingriff. Dabei gibt es abgestufte Möglichkeiten. Eine Simulation im Leitsystem, bei der ein Geräteausfall softwareseitig nachgebildet wird, ist weniger invasiv als ein physischer Test, bei dem eine Einheit tatsächlich abgeschaltet wird. Beide Varianten haben ihre Berechtigung, und beide haben ihre Grenzen. Eine Simulation zeigt, wie die Logik reagiert. Ein physischer Test zeigt, wie die Anlage reagiert.
SIA 2046 beschreibt integrale Tests als Methode, um das Zusammenspiel von Systemen unter realen Bedingungen zu prüfen. Dieser Ansatz ist auf Rechenzentren übertragbar. Ein integraler Test im Rechenzentrum prüft nicht einzelne Geräte, sondern das Verhalten des Gesamtsystems unter definierten Szenarien. Er erfordert eine sorgfältige Vorbereitung, klare Testfälle, eine Rollenzuweisung und einen Abbruchplan für den Fall, dass der Test nicht wie erwartet verläuft.
Wir empfehlen, Redundanztests in einem Wartungsfenster durchzuführen, das mit dem IT-Betrieb abgestimmt ist. Das Wartungsfenster sollte gross genug sein, um den Test vollständig durchzuführen und bei Bedarf abzubrechen und die Anlage in den Normalbetrieb zurückzuführen. Alle Beteiligten, Leittechnik, Kältetechnik, IT und Betrieb, müssen während des Tests erreichbar sein.
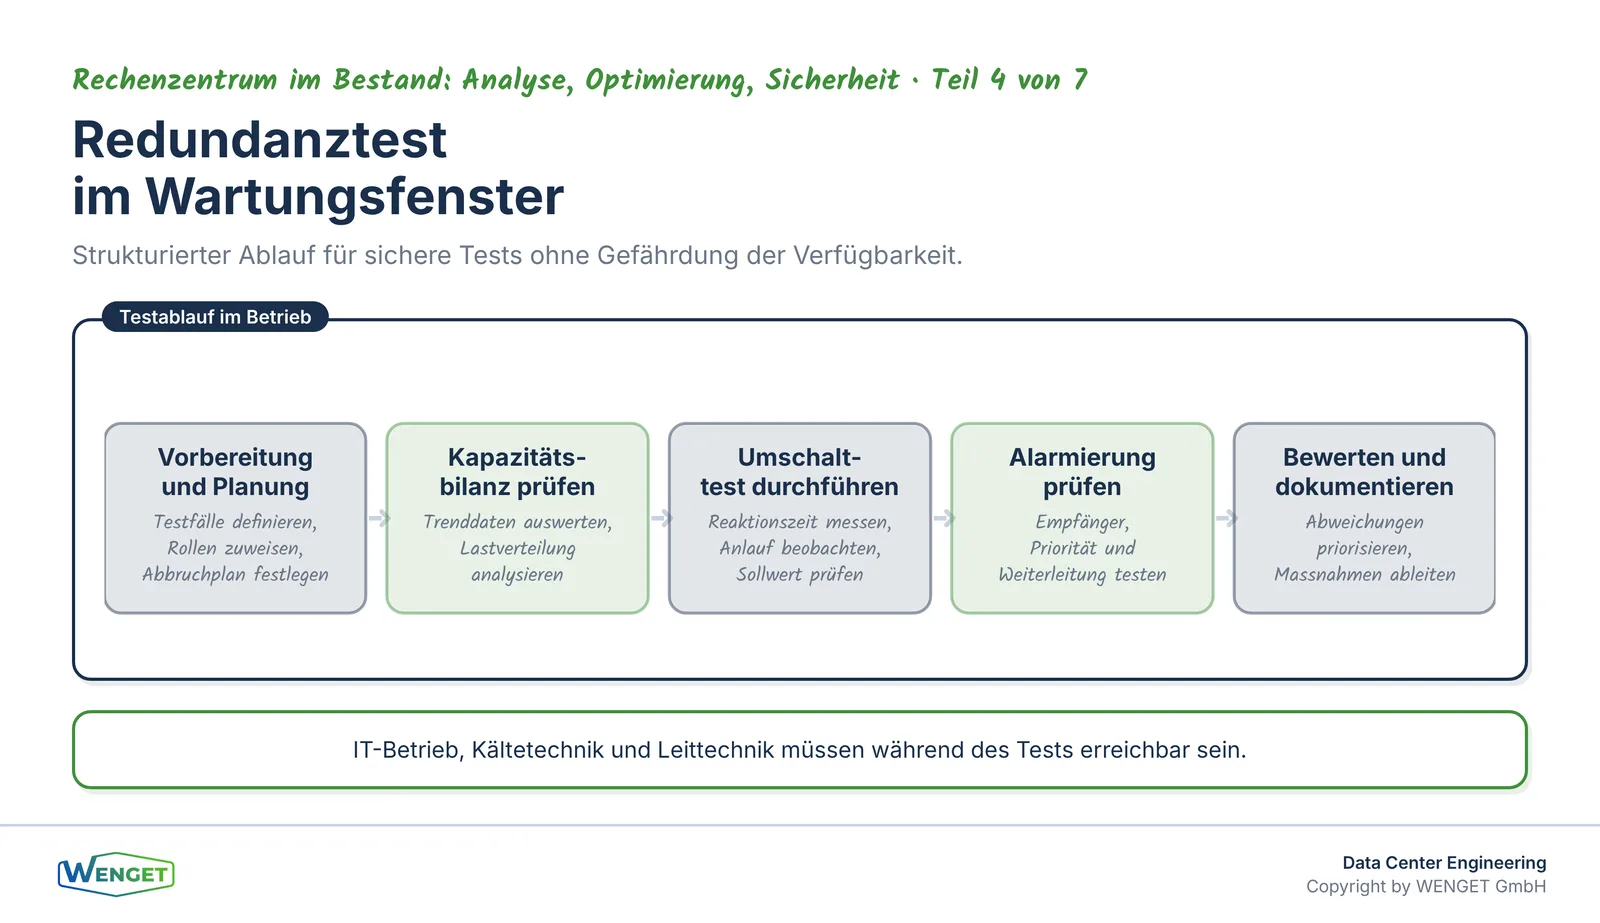
Was ein Redundanztest konkret prüft
Ein vollständiger Redundanztest im Rechenzentrum umfasst mehrere Testfälle. Wir strukturieren diese in drei Gruppen.
Die erste Gruppe umfasst Kapazitätstests. Dabei wird geprüft, ob die verbleibenden Kühleinheiten nach dem simulierten oder realen Ausfall einer Einheit die tatsächliche Last halten können. Massgabe ist nicht die Nennleistung der Einheiten, sondern die gemessene Last unter realen Betriebsbedingungen. Das Ergebnis zeigt, ob die Redundanz kapazitiv noch vorhanden ist.
Die zweite Gruppe umfasst Umschalttests. Dabei wird geprüft, ob die Leittechnik den Ausfall erkennt, die Reserveeinheit aktiviert und die Last übernimmt. Gemessen werden die Reaktionszeit, die Anlaufzeit der Reserveeinheit und die Zeit bis zur Stabilisierung des Sollwerts. Diese Werte werden mit den ursprünglichen Planungsvorgaben verglichen.
Die dritte Gruppe umfasst Alarmierungstests. Dabei wird geprüft, ob der Störfall korrekt alarmiert wird, die Alarmierung die richtigen Empfänger erreicht und die Alarmpriorität dem tatsächlichen Schweregrad entspricht. Alarmmanagement im Rechenzentrum ist ein eigenes Thema, das wir in Teil 5 dieser Serie, «Alarmflut im Leitstand: Alarmmanagement im Rechenzentrum», ausführlich behandeln.
Die Ergebnisse aller Testfälle werden dokumentiert. Abweichungen von den Planungsvorgaben werden bewertet und priorisiert. Das Ergebnis ist kein Prüfbericht im formalen Sinn, sondern eine Grundlage für konkrete Massnahmen.
Bezug zum Commissioning und zur Verfügbarkeitsklasse
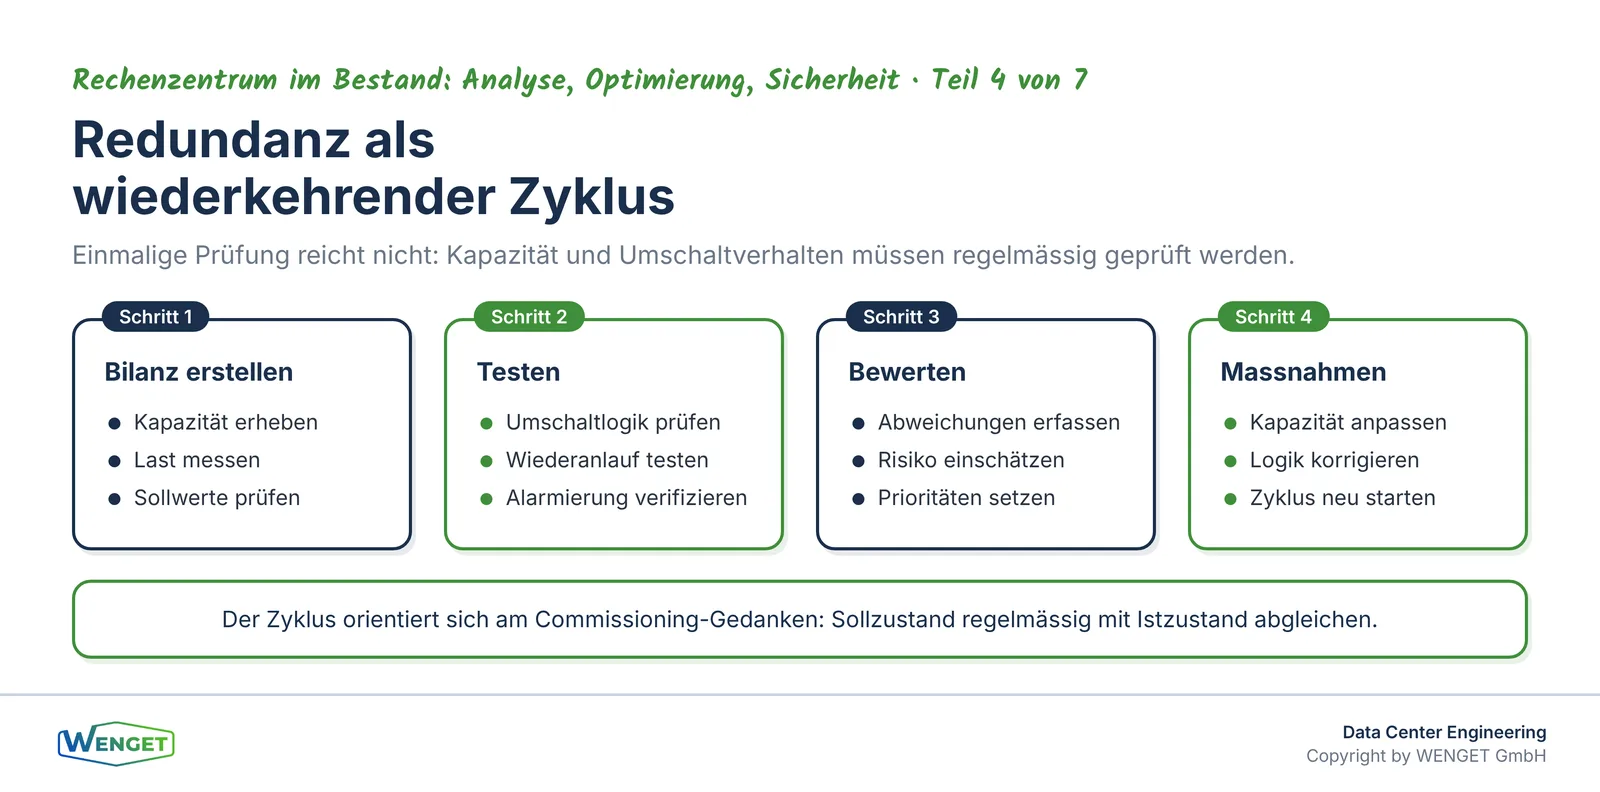
Redundanztests im Bestand sind keine einmalige Massnahme. Sie sind Teil eines wiederkehrenden Prüfzyklus, der sicherstellt, dass die Anlage die Verfügbarkeitsklasse, für die sie ausgelegt wurde, auch nach Jahren noch erfüllt. Die EN 50600-1 beschreibt Verfügbarkeitsklassen, die unterschiedliche Anforderungen an Redundanz, Wartbarkeit und Ausfallsicherheit stellen. Diese Anforderungen gelten nicht nur zum Zeitpunkt der Inbetriebnahme, sondern über den gesamten Betrieb.
Das Commissioning bei der Inbetriebnahme legt die Grundlage. Es dokumentiert den Sollzustand und prüft, ob die Anlage diesen Sollzustand erfüllt. Im Bestand geht es darum, diesen Sollzustand regelmässig mit dem Istzustand abzugleichen. Wie Commissioning-Stufen im Rechenzentrum aufgebaut sind und was sie leisten, beschreibt Teil 1 der Serie «Leittechnik im Rechenzentrum», «Commissioning L1 bis L5 im Rechenzentrum einfach erklärt».
Ein Redundanztest im Bestand ist in diesem Sinne ein rückwirkender Commissioning-Schritt. Er prüft, ob die Anlage noch das leistet, was sie beim Commissioning geleistet hat. Wenn nicht, zeigt er, wo die Abweichungen liegen und was zu tun ist.
Der rote Faden zu unseren Fachbeiträgen
Dieser Artikel steht im Zusammenhang mit mehreren anderen Teilen unserer Serien. Teil 1 dieser Serie, «Leittechnik-Check im bestehenden Rechenzentrum», beschreibt, wie man den Istzustand der Leittechnik systematisch erhebt. Teil 2, «Was die Trenddaten über Ihre Kühlung verraten», zeigt, wie Betriebsdaten genutzt werden, um Kapazitätsprobleme frühzeitig zu erkennen. Teil 3, «Betriebsoptimierung der Kühlung ohne Risiko für die Verfügbarkeit», behandelt, wie Optimierungen so umgesetzt werden, dass die Redundanz erhalten bleibt.
Teil 5 dieser Serie, «Alarmflut im Leitstand: Alarmmanagement im Rechenzentrum», vertieft das Thema Alarmierung, das für die Erkennung von Störfällen entscheidend ist. Teil 6, «Security-Analyse der Leittechnik im Bestand», und Teil 7, «Fernzugänge und Lieferanten: das unterschätzte Einfallstor», ergänzen die Bestandsanalyse um die Sicherheitsperspektive.
Aus der Serie «Leittechnik im Rechenzentrum» ist Teil 1, «Commissioning L1 bis L5 im Rechenzentrum einfach erklärt», besonders relevant, weil er den Zusammenhang zwischen Commissioning und laufendem Betrieb erklärt. Für Fragen rund um Funktionstests und integrale Tests empfehlen wir ausserdem unseren Beitrag «SIA 2046 in der Praxis: Integrale Tests Schritt für Schritt» aus der Serie zu Funktionskontrollen und Integrationstests.
Fazit
N+1 ist kein dauerhafter Zustand, der sich von selbst erhält. Lastwachstum, veränderte Sollwerte, Softwareanpassungen und bauliche Veränderungen höhlen die Redundanz unbemerkt aus. Das Risiko ist nicht, dass jemand einen Fehler gemacht hat. Das Risiko ist, dass viele kleine Veränderungen zusammengekommen sind, ohne dass die Redundanzbilanz je neu gerechnet wurde.
Eine Lastprüfung zeigt, ob die Kapazität noch ausreicht. Ein geprüftes Umschaltverhalten zeigt, ob die Leittechnik im Störfall das tut, was sie soll. Ein Wiederanlauftest zeigt, ob das Gesamtsystem nach einem Netzausfall koordiniert hochfährt. Diese drei Prüfungen zusammen ergeben ein reales Bild der Redundanz, das auf Messung und Test beruht, nicht auf Planungsannahmen von vor Jahren.
Wir empfehlen, diese Prüfung in einem strukturierten Wartungsfenster durchzuführen und die Ergebnisse zu dokumentieren. Das schafft Klarheit für Betreiber, Risikoverantwortliche und Bauherrenvertretungen und ist die Grundlage für gezielte Massnahmen, wenn die Redundanz nicht mehr dem Sollzustand entspricht.
Sie haben Fragen dazu?
Sie möchten wissen, ob die Redundanz in Ihrem Rechenzentrum noch dem entspricht, was bei der Planung vorgesehen war? Wir unterstützen Sie bei der Kapazitätsbilanz, der Analyse der Umschaltlogik und der Vorbereitung und Durchführung von Redundanztests im Betrieb. Nehmen Sie Kontakt auf über wenget.ch oder info@wenget.ch.
Quellenverzeichnis
- EN 50600-1: Einrichtungen und Infrastrukturen von Rechenzentren, Teil 1: Allgemeine Konzepte (Verfügbarkeitsklassen)
- EN 50600-2-3: Einrichtungen und Infrastrukturen von Rechenzentren, Teil 2-3: Umgebungsbedingungen
- Uptime Institute: Tier Standard: Topology (Tier I bis IV, Redundanzbegriffe N, N+1, 2N)
- ASHRAE TC 9.9: Thermal Guidelines for Data Processing Environments (empfohlener Zulufttemperaturbereich 18 bis 27 °C)
- SIA 2046: Integrale Tests von Gebäuden und Anlagen (Methodik für integrale Funktionstests)
- Eigene Projekterfahrung der WENGET GmbH aus Bestandsanalysen, Leittechnik-Checks und Redundanzprüfungen in Rechenzentren
Feedback, Kritik, Lob oder Rückfragen?
Das können Sie auch über LinkedIn tun. Schreiben Sie uns auf unserer LinkedIn-Seite.
Passende Leistung
Data Center Engineering
Weitere Artikel zu Data Center Engineering
Alarmflut im Leitstand: Alarmmanagement im Rechenzentrum
Alarmflut im Rechenzentrum vermeiden: Wie ein Alarmaudit nach IEC 62682 Prioritäten klärt, Meldungen reduziert und die Verfügbarkeit erhöht.
Security-Analyse der Leittechnik im Bestand
Wie analysiert man die OT-Sicherheit im Rechenzentrum? Inventar, Zonen-Modell nach IEC 62443, Gap-Analyse und Massnahmenplan Schritt für Schritt erklärt.
Fernzugänge und Lieferanten: das unterschätzte Einfallstor
Vergessene Modems, offene VPN-Konten, unkontrollierte Fernwartungsboxen: Wie Betreiber Fernzugänge zur Leittechnik sicher und nachvollziehbar gestalten.
Sie haben eine konkrete Frage zu Ihrem Projekt?
Wir schätzen Ihre Situation gerne in einem unverbindlichen Erstgespräch ein.
Kontakt aufnehmen